一、一本新书,把词元讲成一条产业链
2026年10月21日,由腾讯研究院和金融科技50人论坛联合学术支持的“词元经济理论、实践与政策研究”成果——《一本书读懂词元经济》,在2026金融街论坛年会金融街之声“金融街发布”活动上正式发布。该书由杨涛、杜晓宇主编,人民日报出版社2026年10月出版。
杜晓宇是腾讯研究院副院长。序言里他交代了自己的路径:2003年大学毕业后进入人民银行系统,先后在条法、支付结算岗位工作,后到中国支付清算协会从事金融科技领域的自律管理,再到腾讯研究院。几段经历都与 Token 这个词有关,这本序言因此带上了行业史与个人经验交织的写法。
序言要回答的问题并不轻:词元经济与已经耳熟能详的数字经济、数据要素是什么关系,产业边界划到哪里、统计口径怎么定,计量该用哪把尺子,商业模式靠什么走通。原文的组织方式是先给定义,再讲动力,最后落到定价与人的位置。
二、同一个词,二十多年换了三次身份
Token 在中文里没有唯一译名,原文按时间顺序给出三次改名,每一次都踩在一轮技术浪潮的节点上。
| 时期 | 中文名 | 主要场景 | 当时的核心争点 |
|---|---|---|---|
| 支付结算 | 令牌 | 将银行卡号等支付交易信息替换,让真实信息不在交易链路里裸奔 | 交易安全 |
| 区块链 | 通证 | 区块链产业与“通证经济学” | 通证算不算一种新的价值载体、是不是互联网 3.0 |
| 大模型 | 词元 | 大语言模型处理信息的最小单位 | 围绕词元的生成、流通、交易与应用 |
原文提到,翻译方案还有分词、词元、智元等几种,作者在几次发言中都建议统一为“词元”,理由是“信、达、雅都具备”,也避免了翻译中需要规避的地方。至于词元经济中的“词元”,原文明确不再赋予玄乎的新含义:它就是大模型处理信息的最小单位。所谓词元经济,是以这个最小单位为计量基础,把围绕词元的生成、流通、交易和应用串起来的一整套智力服务新业态。
这里有一处容易被忽略的表述:原文强调,即便将来不用词元计价、或者词元消耗减少了,也不影响“词元经济”这个名称成立。“银发经济说的不是白发,冰雪经济说的不是冰天雪地”,词元经济所代表的不是 Token 这串字符,而是它背后正在长出来的那条产业链。
三、词元的份量:智力第一次有了标准化计量单位
原文认为,词元真正的份量在于它让“智力”第一次有了标准化的计量单位。在这之前,智力服务的价钱总和人绑在一起:咨询按人天报价,律师按小时核算,翻译按千字收费。算的都是“谁干了多久”,不是“交付了多少脑力成果”。智力没法从具体的人身上剥离出来,自然也没法标准化地定价和交易。词元改变了这件事——一次法律咨询的来回,可以用词元数量计量出来,智力服务从此有了类似电力行业“千瓦时”那样的标尺。
按:这个类比在普惠金融语境里值得停一下。“千瓦时”能成为标尺,靠的不只是单位名称,而是电的同质性加上统一的计量与结算体系。词元要走到那一步,需要的是可核验的计量、可比的报价与可执行的结算规则。
原文自己把边界划得很清楚:词元和千瓦时不一样。电是同质的,一度就是一度;不同模型、不同任务产出的词元,智能密度差得远。所以词元作为计量单位是成立的,作为价值尺度,还得再乘上一个质量系数。
四、词元经济因 Agent 而兴
原文把词元经济的兴起放在 2026 年的一个变化上:主流模型之间的差距在收窄,竞争的重心从“谁的模型更强”挪到“谁能把模型用好”。模型本身只是发动机,真正让产业起来的是 Agent——它把模型嵌进具体的业务流程,分解任务、调用工具、串起一整套工作流,词元的消耗才从对话问答的小尺度,跳到驱动业务的大尺度。
门槛主要在工程上,不在模型本身。原文给出一组印象很深的数字:同一个模型,一字没改,只换了外面的工程框架,编程任务的成功率就能从 42% 跳到 78%。Agent 要真正在一个行业里跑通,背后是大量的数据治理、流程改造、知识沉淀和权限设计。
也正因如此,原文对“只把钱砸在算力”持保留态度。如果消耗端停留在让大模型陪人聊天、替人写文案,词元的增长就只是简单的内容替代;智力成果被大批量供给,而可承接智力的真实业务没有同步增长,结果就是智力产能过剩,而且往往是低水平的智力产能过剩。真正的增量来自 Agent 对金融、医疗、法律、制造、政务、教育、跨境贸易等行业的带动——那些原本因人力成本高昂、专业门槛太陡而效率低下的业务,因为 Agent 能以可承受的成本介入,开始变得可落地推进。
原文举了一个数据交易的例子:原始数据一旦出库,权属和安全都难以管控,可不出库又卖不动。换个思路,把数据先分层处理、再训练成垂直 Agent,对外开放的不是数据本身,而是模型与 Agent 的能力,按调用计费、按场景结算,数据“可用不可见、可用不可取”,交易反而走通了。
关于所处阶段,原文的判断是“还很早”,并给出 Agent+ 的三个阶段:
- 拿着锤子找钉子。技术先铺开,到处试场景。
- 把体验做到极致。每次大模型迭代、每次 Agent 升级,都把很多应用变成内化的组件,最后大概会出现一个 AI 领域的 Office,使 AI 可以被便捷、标准化地使用,使用 AI 越来越不需要复杂的准备工作。
- Agent 也许能完全替你思考。自我迭代、自己干活,再去找其他 Agent 干活,考验的是 Agent 对用户的理解能力和自进化能力,而非用户的提示词。
五、定价:按数量算的是成本,不是价值
原文指出,目前主流的计价方式是“按词元数量计费”或“按订阅打包”,两条路都有结构性的毛病。
| 计价方式 | 结构性毛病 |
|---|---|
| 按词元数量计费 | 算的是成本不是价值:同样一百万词元,拿去闲聊值不到一美元,拿去做法律审阅可能值上千美元,能差上千倍,用户付的却是同一档单价 |
| 按订阅打包 | 低价订阅碰上重度用户,越用越亏 |
| 免费加广告 | 社交、搜索服务每增加一个用户几乎不增加成本,大模型却是每一次推理都在真金白银烧算力,规模越大亏得越多 |
国际上已经有人在试新路子,比如按解决的工单收费、按完成的合同收费,把计价标准从供给侧的“用了多少”转向需求侧的“做成了什么”。中国市场的难处还要更深一层:C 端用户习惯免费,B 端习惯了打价格战,主流模型的 API 标价只有美国同类的一到两成甚至更低。厂商一边要扛同等量级的研发投入,一边要在低得多的回报水位上参与竞争,盈利空间被两头挤。原文因此提出,这可能不是单个企业扛得动的,需要政策引导市场回归价值定价。
衡量词元经济的成色,原文建议换一把尺子:别只数它消耗了多少词元,更要看每一单位词元产出了多少经济价值。就像看一个国家的电气化水平,不能只看发了多少度电,还得看每度电创造了多少 GDP。
六、人与 AI:三项加起来才是人的位置
原文不认同一种流行说法——“会用 AI 的人不会被淘汰,不会用的才会”。它把冲击分成两层看。一层是岗位:被替代其实不是因为不会用 AI,而是因为干的活不如 AI 干得好、干得便宜;但这样的场景很少,往往是一些成本原因导致的裁员被包装成了高大上的 AI 裁员叙事。另一层是行业:有些行当会整个消失,这时会不会用 AI 都留不住人,唯一的出路是带着原来的本事,转身加入被 AI 重塑过的新行业。等哪天 AI 工具普及得像 Word 一样,会不会用 AI 这道槛本身也就不存在了。
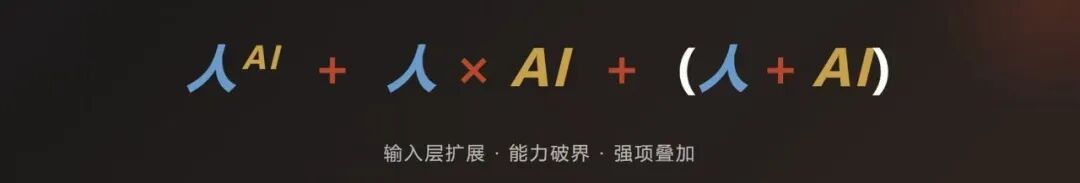
- 人的 AI 次方,讲输入端。AI 以指数级放大人的认知边界,一个人借助 AI 能接触到的信息、能调度的工具、能快速掌握的能力,比过去高出几个数量级。
- 人乘以 AI,讲补短板。不会写代码的人可以借助 AI 写出能跑的程序,不懂法律的人可以借助 AI 看懂一份合同。但如果你对相关知识一点都不了解,人的数值是 0,这个算式其实无意义;在完全不懂的领域,不可能靠 AI 做出真正有价值的内容,往往产生“数字泔水”。
- 人加 AI,讲强强联手。在人本来就擅长的领域,AI 是一把放大器。AI 技术水平相当的情况下,人才是根本:擅长做 PPT 的人,AI 能帮着处理得更快,但不一定比自己做得好;汪曾祺讲写文章要有文气,擅长写文章的人大概看不上完全用 AI 生成的内容,会觉得文字平平,改起来却很麻烦。
三项加起来,才是词元经济里人的位置。人不是被替代,也不是简单地会用 AI 工具,而是借着 AI 把自己的认知、能力、判断推到更远的地方。
七、按:三个可以接进普惠金融研究的问题
按:以下为个人读后观察,不代表原书与原公众号观点。
其一,计量单位要变成信用凭证,先得可核验。词元若真要充当智力服务的“千瓦时”,前提是消耗记录能被第三方核验。这与普惠金融里正在发生的一件小事方向一致:广州的“Token贷”已把词元消耗规模、算力服务合同、应收账款与平台流水四类信息纳入授信考核(见本站《词元成为授信凭证》)。两边要面对的是同一个问题——日志能记录消耗,也能被人为放大,正向挂钩必须配套反刷量与审计机制。
其二,质量系数是定价问题,也是合规问题。原文说词元作价值尺度要乘质量系数,这个系数落到信贷、保险与政府采购里,就直接变成定价口径与信息披露义务。不同模型、不同任务的词元不可直接相加,意味着任何以词元计的规模指标都得标注口径,否则口径差异会被误读为效率差异。
其三,“人乘 AI”对普惠金融的能力建设提出了更高要求。“数字泔水”这个提醒很实在:给小微主体和基层从业者配工具,不等于配判断力。工具边际成本下降之后,稀缺的是能把业务问题拆成可交付任务的人。这与前置部署工程师(FDE)在普惠金融中的角色是同一件事(见本站《前置部署工程师》)。
这本书的价值或许不在结论,而在把词元经济从一个技术名词还原成一串可以讨论的经济学问题:计量、定价、组织与人的位置。原文自己也说,书里的判断过几年回头看,对的会有,错的恐怕也不少。对研究者而言,能被证伪的判断,比漂亮的论断更有用。
参考资料
- 原文:杜晓宇《Token三次改名背后,藏着 AI 经济的草蛇灰线》,腾讯研究院,2026-10-21 — mp.weixin.qq.com/s/_rrSau-_yBWtWmmJx7ZinA
- 书目:杨涛、杜晓宇主编《一本书读懂词元经济》,人民日报出版社,2026 年 10 月出版
- 站内相关:词元成为授信凭证:从广州Token贷看词元经济的地方布局
- 改写日期:2026-10-22(事实、数字与引述保留原文口径,评述部分以“按”标注)
评论
加载中…