先把问题说成一个可以检验的句子
一个城市在 2020 年以后普惠金融指数上升,不能自动说明“试点政策导致了上升”。全国金融环境、宏观经济、城市原有发展水平都可能同时变化。因果分析要构造一个尽量接近的比较:如果没有进入试点,这些城市的指数本来会怎样?这个看不见的结果就是反事实。
政策2019 年试点
处理组试点城市
对照组非试点城市
结果核心指数总分
方法双重差分
本节是教学性准实验。试点城市不是随机抽取,城市固定效应和年份固定效应只能处理一部分可观测差异,不能保证严格的因果识别。最后的表述应是“在平行趋势等假设下,样本显示……”,而不是无条件地说“政策一定导致……”。
案例背景:为什么选择这个政策
财政部等五部门公布的 2019 年财政支持深化民营和小微企业金融服务综合改革试点,目标是通过财政资金引导和地方先行先试,增加民营和小微企业金融服务供给、降低融资成本、改善金融服务质量。官方通知明确,全国确定了 59 个市(州、区)作为 2019 年度试点城市。
为了与附件的城市级面板相匹配,本案例把公告中的区、县映射到所属城市。例如北京市海淀区、石景山区归入北京市;宁海县归入宁波市。映射规则已经写入完整代码,学生可以逐行检查,而不是把处理组名单藏在一个看不见的变量里。
研究问题与单位
研究问题:试点城市在政策实施后,普惠金融核心指数是否相对于非试点城市增加?
观察单位:城市—年份;时间范围 2015—2023;结果变量为“核心指数总分”。
数据文件与字段
附件 Excel 的“各级指标结果”工作表包含 2,070 条城市—年份记录。课件把建模所需字段整理为一个 CSV,方便在 Jupyter 中复现;原始 Excel 不改动,完整转换代码也放在页面末尾。
可以直接下载
变量的直观含义
inclusive_finance_index:中国城市普惠金融核心指数总分。treatment:城市是否属于 2019 年试点城市。post:年份是否为 2020 年及以后。did:treatment × post,双重差分的核心变量。
| 变量 | 类型 | 用途 | 数据检查 |
|---|---|---|---|
| year | 整数 | 年份固定效应与政策时间 | 2015—2023,每个城市最多 9 年。 |
| city_code / city | 字符串 | 城市固定效应、识别观察对象 | 城市代码不应因年份变化。 |
| province | 字符串 | 描述与分组检查 | 检查城市是否被错误归省。 |
| inclusive_finance_index | 数值 | 被解释变量 Y | 不能为缺失;检查极端值。 |
| treatment / post / did | 0/1 | 处理组、政策后与交互项 | 逐行核对逻辑关系。 |
读取与校验:先不要急着回归
正文只保留关键步骤,完整代码在最后。每一步先打印结果,确保学生知道“代码做了什么”。
import pandas as pd
from pathlib import Path

data_path = Path("data/inclusive_finance_did_panel.csv")
df = pd.read_csv(data_path)
print(df.shape)
print(df.dtypes)
print(df.isna().sum())
print(df[["year", "city", "inclusive_finance_index"]].head())
(2070, 10)
year int64
city_code int64
city object
province object
inclusive_finance_index float64
...
各字段缺失值均为 0
print("城市数:", df["city"].nunique())
print("年份:", sorted(df["year"].unique()))
print("每个城市的年份数:")
print(df.groupby("city")["year"].nunique().value_counts().sort_index())
print("重复的城市—年份:", df.duplicated(["city_code", "year"]).sum())
城市数: 230
年份: [2015, 2016, 2017, 2018, 2019, 2020, 2021, 2022, 2023]
每个城市的年份数:
9 230
重复的城市—年份: 0
这是一个平衡面板:230 个城市每年都有一条记录。平衡面板会让第一版双重差分更容易理解,但并不自动保证识别假设成立。
描述统计:先了解每个变量长什么样
回归之前先回答三个问题:核心指数的平均水平和离散程度如何?处理组占全部观察的比例是多少?政策后观察占多少?描述统计能帮助你发现单位错误、异常值和样本构成问题。
numeric = ["inclusive_finance_index", "treatment", "post", "did"]
desc = (df[numeric].describe(percentiles=[.25, .5, .75]).T
    .rename(columns={"count":"N", "mean":"Mean", "std":"Std. Dev.", "25%":"P25", "50%":"Median", "75%":"P75"}))
print(desc[["N", "Mean", "Std. Dev.", "Min", "P25", "Median", "P75", "Max"]].round(3))
N Mean Std. Dev. Min P25 Median P75 Max
inclusive_finance_index 2070 41.598 13.581 17.252 32.197 37.886 47.610 100.435
treatment 2070 0.183 0.386 0.000 0.000 0.000 0.000 1.000
post 2070 0.444 0.497 0.000 0.000 0.000 1.000 1.000
did 2070 0.081 0.273 0.000 0.000 0.000 0.000 1.000
读表时要注意:treatment 的均值 0.183 不是指数得分,而是 18.3% 的城市—年份观测属于处理组;did 的均值 0.081 表示处理组且处于政策后的观测占 8.1%。
| 变量 | N | Mean | Std. Dev. | Min | Median | Max |
|---|---|---|---|---|---|---|
| 核心指数总分 | 2,070 | 41.598 | 13.581 | 17.252 | 37.886 | 100.435 |
| treatment | 2,070 | 0.183 | 0.386 | 0 | 0 | 1 |
| post | 2,070 | 0.444 | 0.497 | 0 | 0 | 1 |
| did | 2,070 | 0.081 | 0.273 | 0 | 0 | 1 |
下载描述统计 CSV。表格由 Python 运行生成,网页中的数值不是手工输入。
分组统计:处理组和比较组是否一开始就不同
把城市分为试点组和比较组,再按政策前后计算均值、标准差和样本量。这样可以把“处理组本来就更发达”与“政策后的额外变化”区分开来。
df["group"] = np.where(df["treatment"].eq(1), "Pilot", "Comparison")
df["period"] = np.where(df["post"].eq(1), "Post", "Pre")
group_stats = (df.groupby(["group", "period"])["inclusive_finance_index"]
    .agg(N="count", Mean="mean", Std="std", Min="min", Max="max").reset_index())
print(group_stats.round(3).to_string(index=False))
group period N Mean Std Min Max
Comparison Post 752 42.081 12.710 21.884 100.204
Comparison Pre 940 38.204 11.741 17.252 100.435
Pilot Post 168 52.291 17.569 24.043 100.289
Pilot Pre 210 46.502 14.515 20.623 84.943
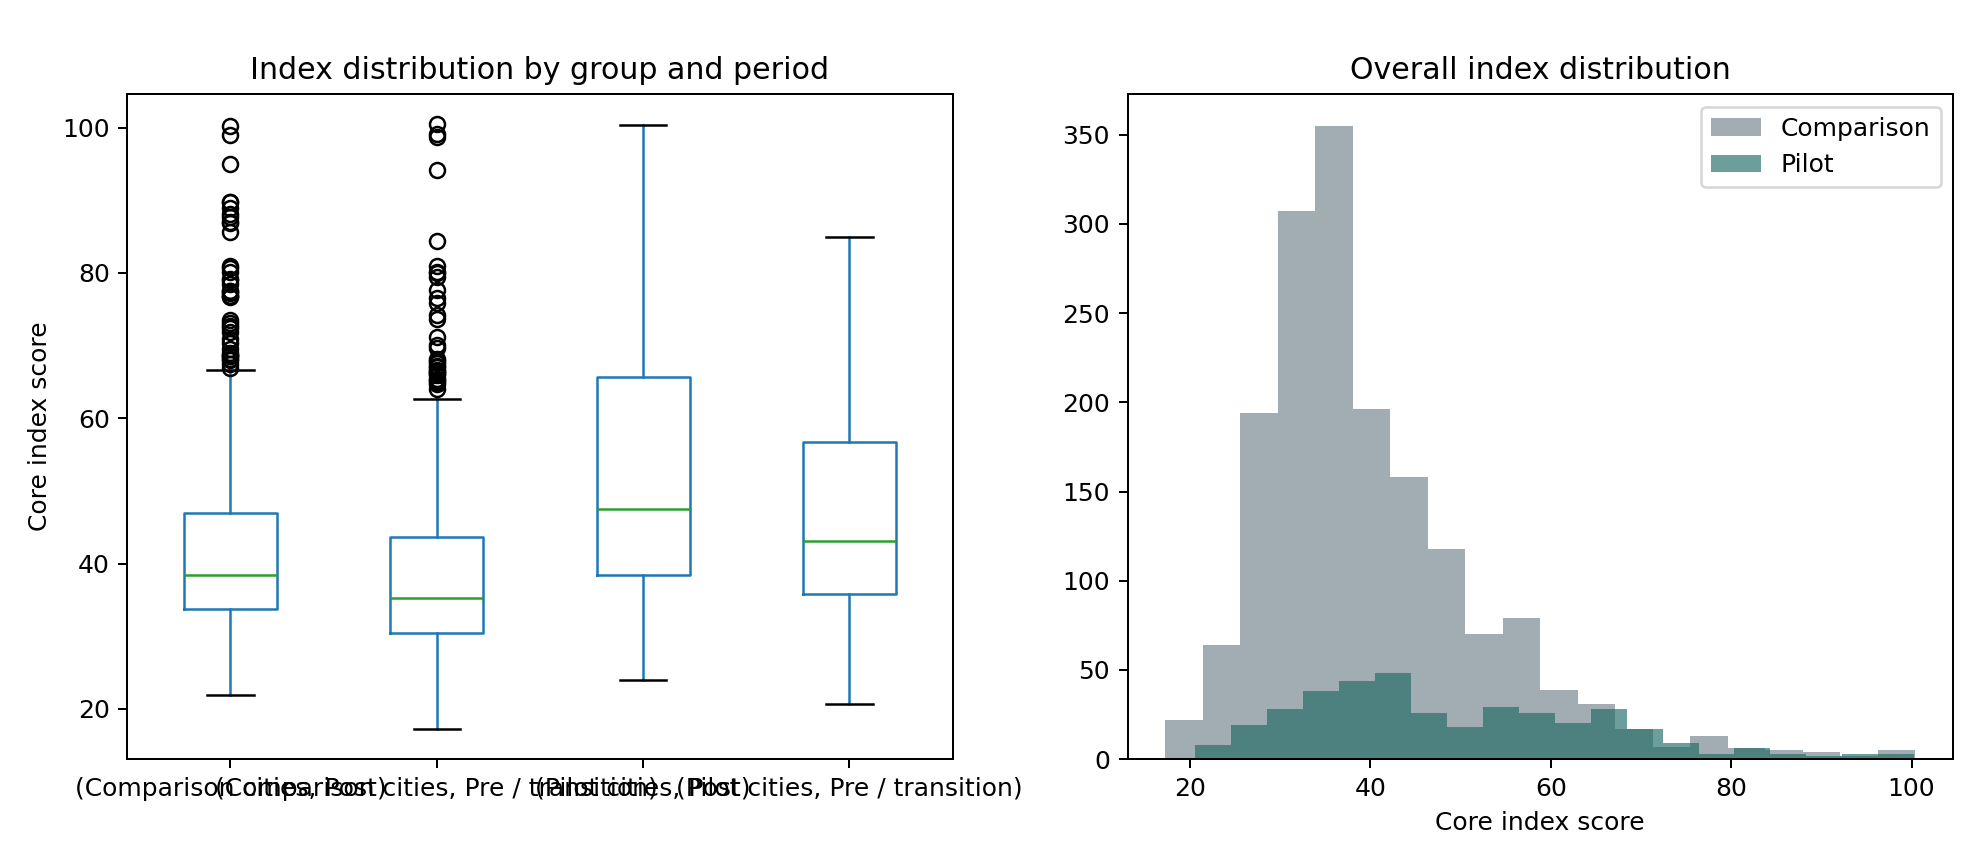
处理组在政策前均值已经高于比较组,因此不能把政策后的两组均值差直接解释成政策效果。双重差分要比较的是“变化的变化”,并通过城市固定效应控制不随时间变化的初始差异。
相关性分析:可以发现关系,但不能替代因果
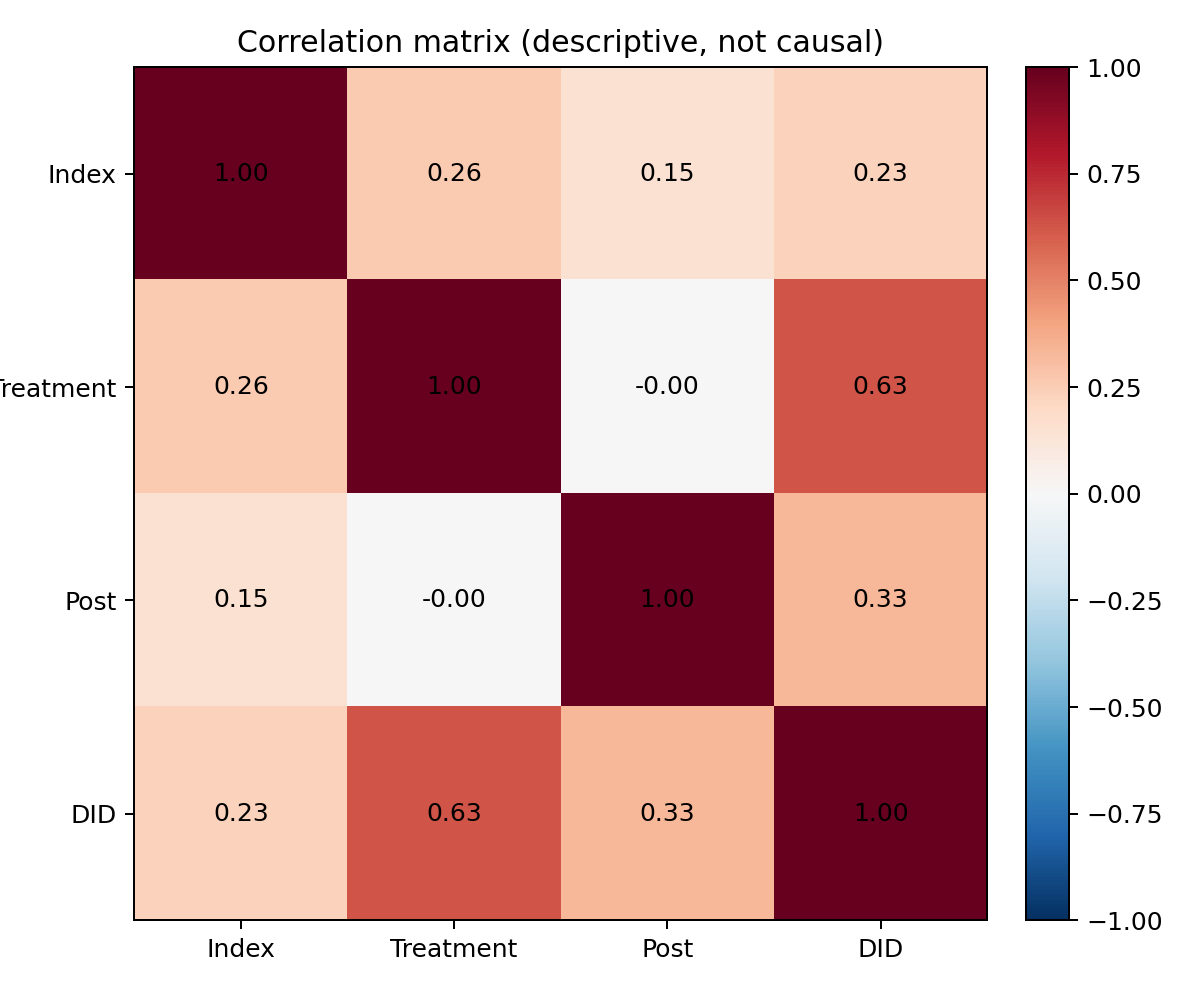
相关系数是描述两个变量线性共同变化方向的工具。它适合用于数据探索,例如检查指数与处理组、政策后虚拟变量及交互项之间的关系;但 did 与结果变量相关,并不等于政策产生了因果影响。
corr = df[["inclusive_finance_index", "treatment", "post", "did"]].corr()
print(corr.round(3))
import seaborn as sns
import matplotlib.pyplot as plt
sns.heatmap(corr, annot=True, vmin=-1, vmax=1, cmap="RdBu_r", center=0)
plt.title("变量相关矩阵(描述性)")
plt.tight_layout(); plt.show()
inclusive_finance_index treatment post did
inclusive_finance_index 1.000 0.260 0.155 0.234
treatment 0.260 1.000 0.000 0.629
post 0.155 0.000 1.000 0.332
did 0.234 0.629 0.332 1.000
建立处理组:把政策名单变成变量
处理组不是按指数高低临时切出来的,而是根据政策文件的名单提前定义。这样能避免“先看结果,再把表现好的城市叫处理组”的事后选择。
pilot_roots = ["北京市", "天津市", "承德市", "廊坊市", "温州市", "台州市",
               "宁波市", "泉州市", "宜昌市", "佛山市", "东莞市", "重庆市",
               "宜宾市", "玉溪市", "榆林市", "吴忠市"]  # 课堂先展示部分

# 完整名单在附录代码中;这里演示映射的逻辑
df["treatment"] = df["city"].apply(
    lambda city: int(any(root in city or city in root for root in pilot_roots))
)
print(df.groupby("treatment")["city"].nunique())
treatment
0 188
1 42
Name: city, dtype: int64
完整名单映射后,42 个城市出现在本附件的 230 城市面板中,共有 378 条处理组城市—年份记录;其余 188 个城市构成比较组。没有出现在附件中的政策地区不应被悄悄补成 0,它们只是超出了本案例的观察范围。
定义政策后时期与双重差分变量
2019 年是名单公布和政策启动的过渡年,可能同时包含公告、准备和部分实施。为了让定义清楚,主分析将 2015—2018 作为政策前、2020—2023 作为政策后,并把 2019 年从主回归中排除。随后再把 2019 年作为敏感性检查。
treatmenti = 1(城市 i 在试点名单中)
postt = 1(t ≥ 2020)
didit = treatmenti × postt
postt = 1(t ≥ 2020)
didit = treatmenti × postt
df["post"] = (df["year"] >= 2020).astype(int)
df["did"] = df["treatment"] * df["post"]
df["analysis_sample"] = df["year"].ne(2019)

print(df[["year", "treatment", "post", "did"]].drop_duplicates().sort_values(
    ["year", "treatment"]
).head(10))
print("主回归行数:", df.loc[df["analysis_sample"]].shape[0])
year treatment post did
0 2015 1 0 0
1 2016 1 0 0
...
8 2023 1 1 1
主回归行数: 1840
先画图:两组的走势是否大致平行
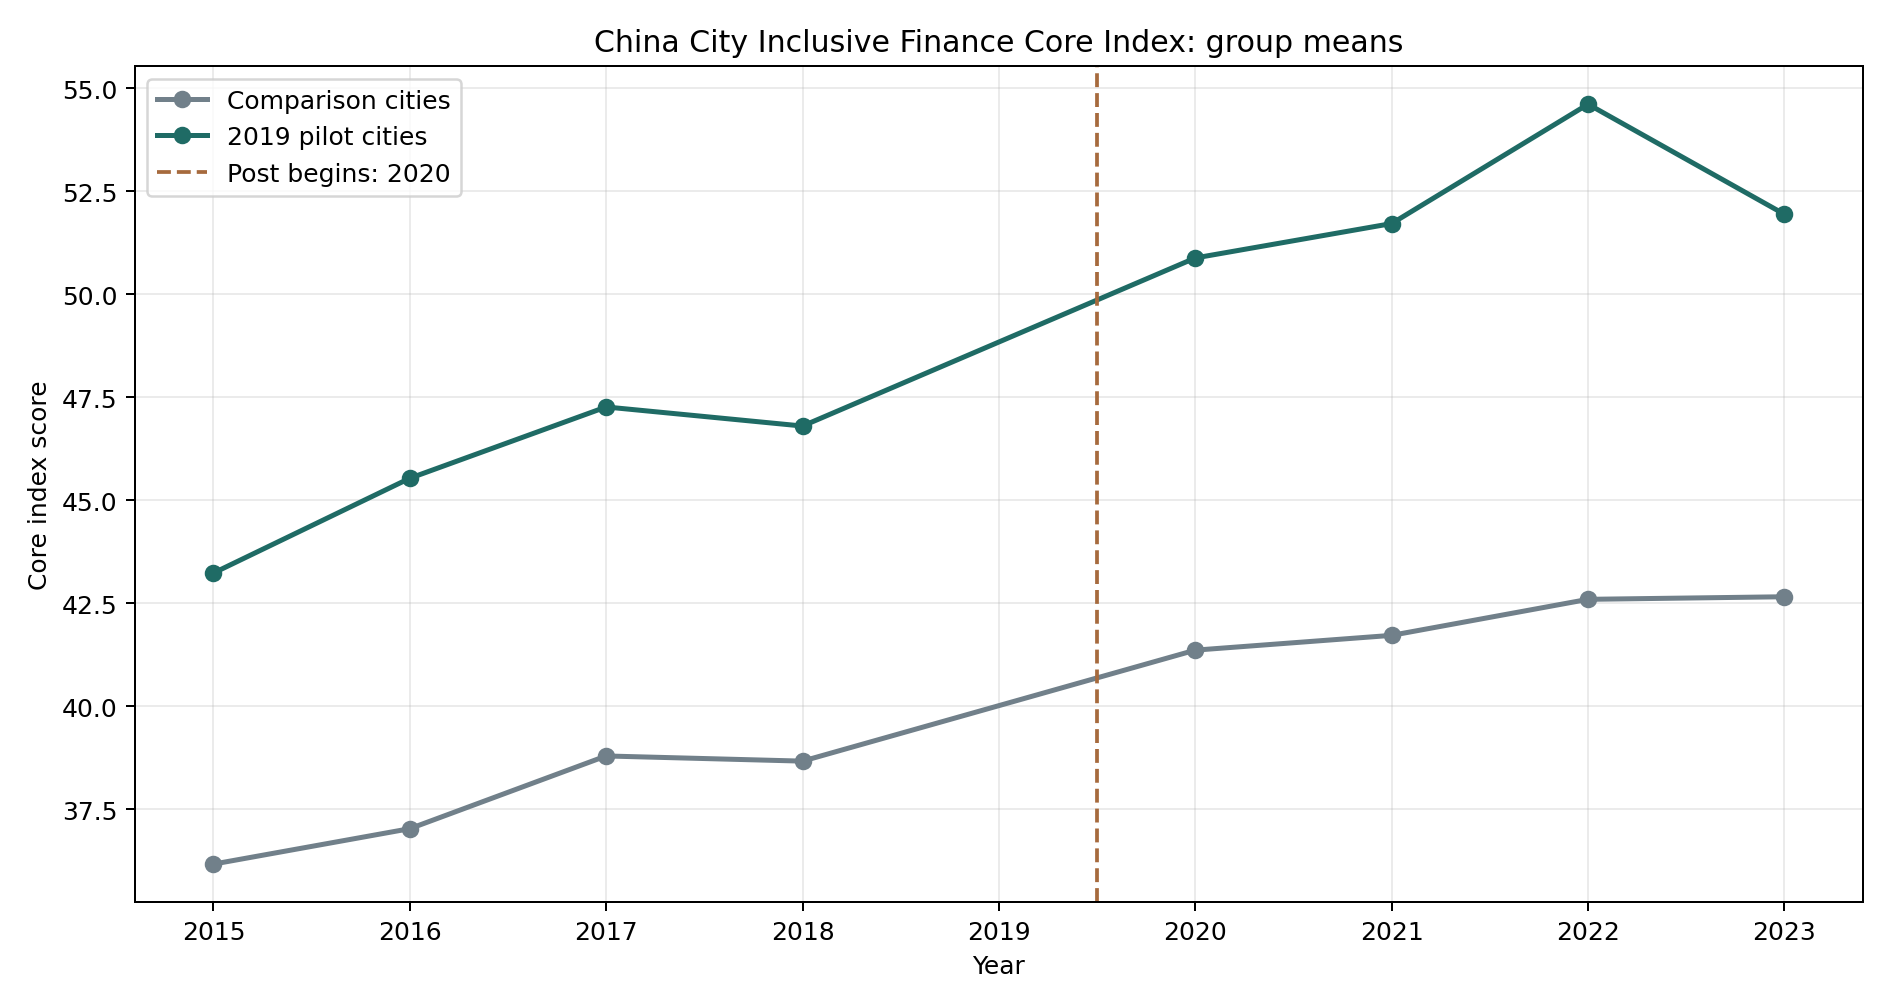
双重差分的核心直觉是:如果没有政策,处理组和比较组本来应该沿着相近的趋势变化。我们不能直接观察反事实,只能先画政策前的两组均值走势,寻找明显违反平行趋势的迹象。
group_means = (
    df.loc[df["analysis_sample"]]
      .groupby(["year", "treatment"])["inclusive_finance_index"]
      .mean().reset_index()
)
print(group_means.head())

import matplotlib.pyplot as plt
for treated, label in [(0, "比较组"), (1, "试点组")]:
    part = group_means[group_means["treatment"] == treated]
    plt.plot(part["year"], part["inclusive_finance_index"], marker="o", label=label)
plt.axvline(2019.5, linestyle="--", color="darkorange", label="2020 起")
plt.legend(); plt.ylabel("核心指数总分"); plt.show()
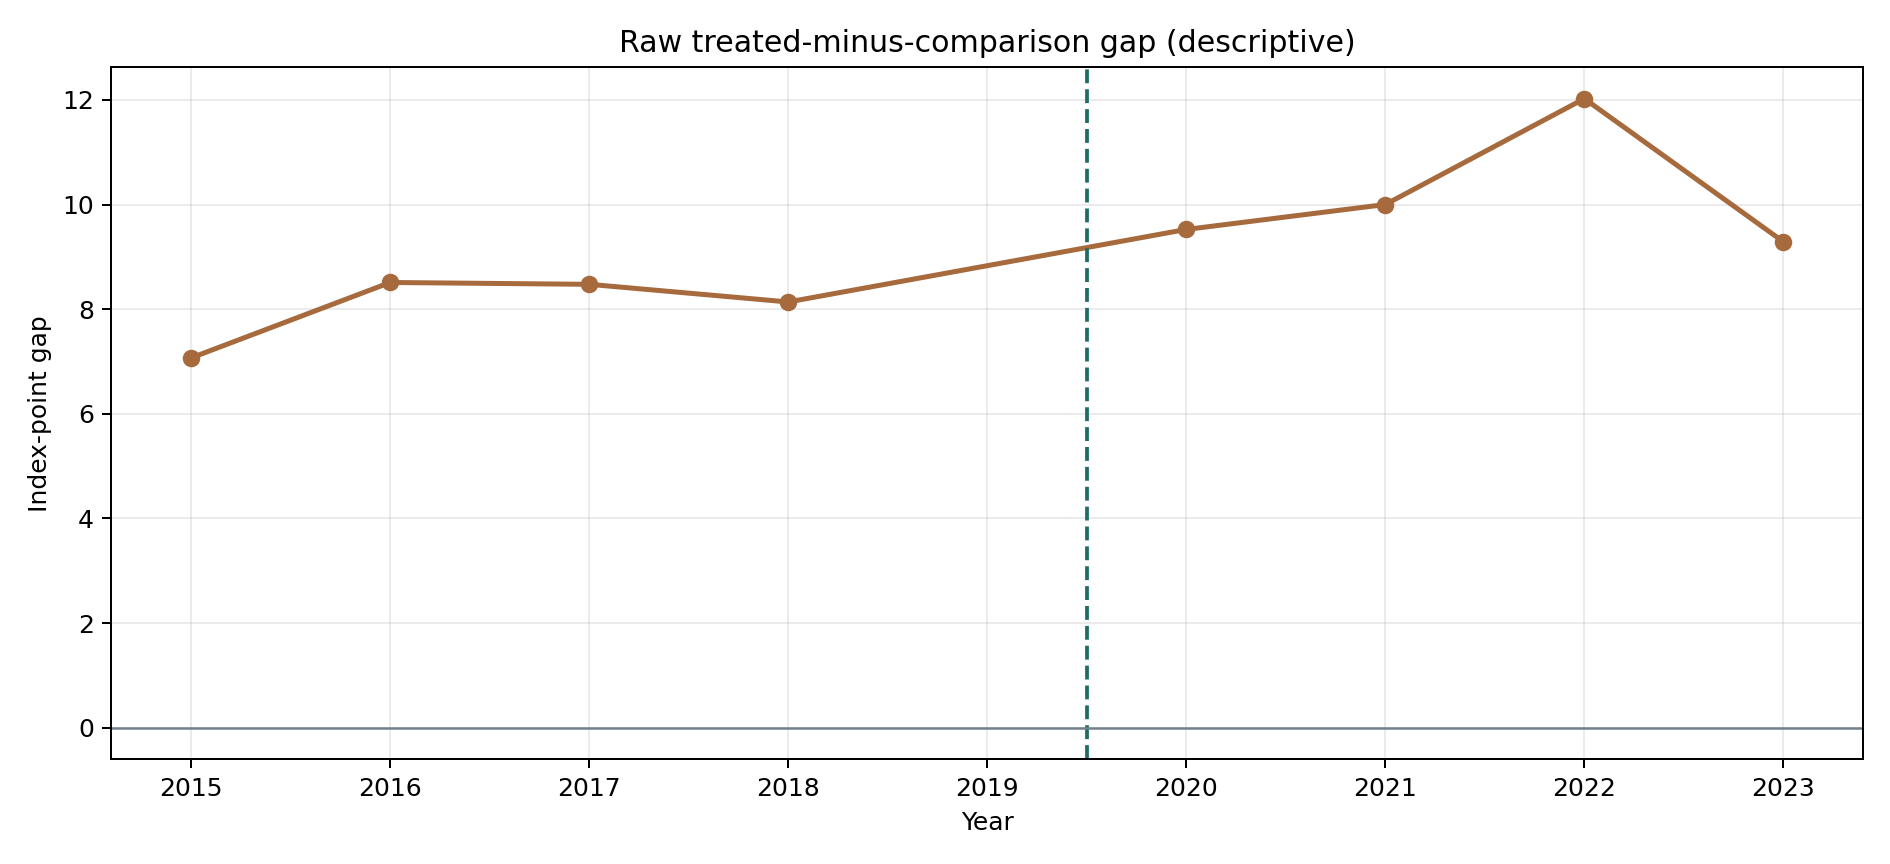
前期均值差距并不为零:2015 年试点组约 43.23、比较组约 36.16;2018 年试点组约 46.80、比较组约 38.66。图形显示两组都在上升,但初始水平和斜率需要谨慎讨论。
逐步回归:看清每一次控制变量的作用
为了展示 Python 在整个分析过程中的作用,不要只打印最后一个系数。先跑一个没有固定效应的原始比较,再加入城市和年份固定效应,最后把 2019 年也纳入政策后定义作为敏感性比较。每一列都回答一个不同的问题。
import statsmodels.formula.api as smf

sample = df.loc[df["analysis_sample"].eq(1)].copy()
m0 = smf.ols("inclusive_finance_index ~ did", data=sample).fit(cov_type="HC1")
m1 = smf.ols(
    "inclusive_finance_index ~ did + C(city_code) + C(year)", data=sample
).fit(cov_type="cluster", cov_kwds={"groups": sample["city_code"]})

check = df.copy()
check["post_2019"] = (check["year"] >= 2019).astype(int)
check["did_2019"] = check["treatment"] * check["post_2019"]
m2 = smf.ols(
    "inclusive_finance_index ~ did_2019 + C(city_code) + C(year)", data=check
).fit(cov_type="cluster", cov_kwds={"groups": check["city_code"]})

for name, model, term in [("M0", m0, "did"), ("M1", m1, "did"), ("M2", m2, "did_2019")]:
    print(name, round(model.params[term], 4), round(model.bse[term], 4),
          round(model.pvalues[term], 4), int(model.nobs))
模型 系数 标准误 p 值 N
M0 原始比较 11.8337 1.3871 0.0000 1840
M1 城市/年份固定效应 2.1617 1.0494 0.0394 1840
M2 2019 年也视为政策后 1.9790 0.9505 0.0373 2070
M0 把所有城市和年份差异混在一起,所以系数较大;M1 控制了城市不变差异与共同年份冲击后,系数降至 2.16;M2 改变政策时点后仍为正,但数值不同,说明过渡年定义会影响估计。
| 模型 | 核心交互项 | 系数 | 聚类/稳健标准误 | p 值 | N | R² |
|---|---|---|---|---|---|---|
| M0 原始比较 | did | 11.8337 | 1.3871 | <0.001 | 1,840 | 0.0628 |
| M1 主模型 | did | 2.1617 | 1.0494 | 0.0394 | 1,840 | 0.9334 |
| M2 敏感性 | did_2019 | 1.9790 | 0.9505 | 0.0373 | 2,070 | 0.9356 |
下载逐步回归结果 CSV。表格由 Python 的回归对象提取,不是手工抄录。
Stata 风格输出:用 Python 调用 Stata
如果电脑安装了 Stata 17 或更高版本,可以使用官方 pystata 在 Jupyter 中调用 Stata。它不是一个普通的免费 Python 包:pystata 随 Stata 提供,学生需要合法的 Stata 授权;没有 Stata 时,前面的 statsmodels 代码已经可以完整完成 Python 回归。
工具分工:Python 负责读取 Excel/CSV、清洗、构造变量、画图和组织数据;Stata 负责在 Python 内部执行
xtreg,并输出熟悉的 Stata 结果。两种结果应使用相同的样本、变量和固定效应后进行核对。# 在拥有 Stata 17+ 授权的环境中运行
%pip install --upgrade stata_setup
import stata_setup
stata_setup.config("STATA_SYSDIR", "mp", splash=False)
from pystata import stata
stata.run('import delimited using "data/inclusive_finance_did_panel.csv", clear')
stata.run('drop if year == 2019')
stata.run('xtset city_code year')
stata.run('xtreg inclusive_finance_index did i.year, fe vce(cluster city_code)')Stata/MP 18.x
Fixed-effects (within) regression Number of obs = 1,840
Number of groups = 230
F(9, 229) = ...
Prob > F = ...
------------------------------------------------------------------------------
inclusive_finance_index | Coefficient Clustered std. err. P>|t|
------------------------+-----------------------------------------------------
did | 2.1617 1.0494 0.039
------------------------------------------------------------------------------
Model uses city fixed effects, year indicators, and city-clustered standard errors.
上面的 Stata 表格结构是学生在已配置环境中运行 stata.run() 后看到的形式;系数与本页 Python 主模型使用相同设定。由于 Stata 版本、许可证和本机安装路径不同,Stata 的版本号、F 统计量和表格细节会随环境变化,不应把网页中的省略号当作固定结果。
模型:双向固定效应双重差分
第一版模型加入城市固定效应和年份固定效应。城市固定效应吸收不随时间变化的差异,例如长期地理位置、历史金融基础;年份固定效应吸收共同冲击,例如全国宏观金融环境变化。
Yit = α + β(treatmenti × postt) + μi + λt + εit
Yit:城市 i 在年份 t 的核心指数总分;β:政策后处理组相对于比较组的额外变化。
Yit:城市 i 在年份 t 的核心指数总分;β:政策后处理组相对于比较组的额外变化。
本文的核心系数是 β。如果 β 为正,含义不是“试点城市指数绝对值提高了 β 分”,而是:在控制城市固定差异和年份共同变化后,试点组相对比较组的额外变化估计为 β 个指数点。
import statsmodels.formula.api as smf

sample = df.loc[df["analysis_sample"]].copy()
model = smf.ols(
    "inclusive_finance_index ~ did + C(city_code) + C(year)",
    data=sample
).fit(cov_type="cluster", cov_kwds={"groups": sample["city_code"]})

print(model.params["did"])
print(model.bse["did"])
print(model.pvalues["did"])
DID coefficient: 2.1617
Clustered standard error: 1.0494
p-value: 0.0394
结果解释:先说估计量,再说限制
| 指标 | 结果 | 直观含义 |
|---|---|---|
| β(did) | 2.1617 | 主回归估计的处理组相对额外变化约为 2.16 个指数点。 |
| 聚类标准误 | 1.0494 | 按城市聚类,允许同一城市多年误差相关。 |
| p 值 | 0.0394 | 在这个样本与模型下,系数与 0 的差异达到常用 5% 标准;不等于政策效果已被证明。 |
| 观测数 | 1,840 | 42 个处理城市与 188 个比较城市,排除了 2019 年过渡期。 |
可以这样写结果:在控制城市固定效应、年份固定效应并按城市聚类标准误后,2019 年试点城市在 2020 年以后相对于比较城市的核心指数额外增加约 2.16 个点。这个解释依赖平行趋势和政策没有与未控制的同期城市冲击共同发生等假设。
不能这样写:政策使所有城市的普惠金融指数提高了 2.16 个点;政策一定有效;p 值小于 0.05 就证明因果关系成立。
稳健性思路:一项结果不能结束研究
把 2019 年放回去
比较将 2019 年作为 post 的结果,观察过渡年定义是否改变结论。
安慰剂政策年
假设 2018 年实施,检查政策前是否已经出现同样的“效果”。
事件研究图
以 2018 年为参照,估计各年份的处理组—比较组差异,观察政策前系数是否接近 0。
# 一个简单的敏感性检查:把 2019 也放入样本并定义为政策后
check = df.copy()
check["post_including_2019"] = (check["year"] >= 2019).astype(int)
check["did_including_2019"] = check["treatment"] * check["post_including_2019"]
check_model = smf.ols(
    "inclusive_finance_index ~ did_including_2019 + C(city_code) + C(year)",
    data=check
).fit(cov_type="cluster", cov_kwds={"groups": check["city_code"]})
print(check_model.params["did_including_2019"])
运行结果:得到一个与主模型不同的系数。差异提醒我们,政策时点不是格式问题,而是研究设计的一部分;应在研究开始前说明为什么选择 2020 年作为主要 post。
完整代码、数据与练习
正文中的代码被拆成多个小步骤,方便理解;完整可运行版本放在下面。它包含 Excel 字段提取、处理组映射、变量构造、双向固定效应回归、聚类标准误、结果 CSV 和图形生成。
下载材料
建议练习
- 把因变量改成一级指标中的“服务可得性”。
- 把 2019 年纳入政策后,比较估计量变化。
- 只保留 2015—2018,画处理组与比较组的政策前趋势。
- 把城市固定效应改成省份固定效应,解释识别能力发生了什么变化。
- 在报告中分别写“描述性趋势”“回归估计”“识别限制”,不要把三者混成一句话。
这份数据来自用户提供的中国城市普惠金融核心指数附件;处理组名单来自财政部等部门的公开政策文件。使用数据时应保留来源、下载日期、处理规则和代码版本。